Biaya Cetak
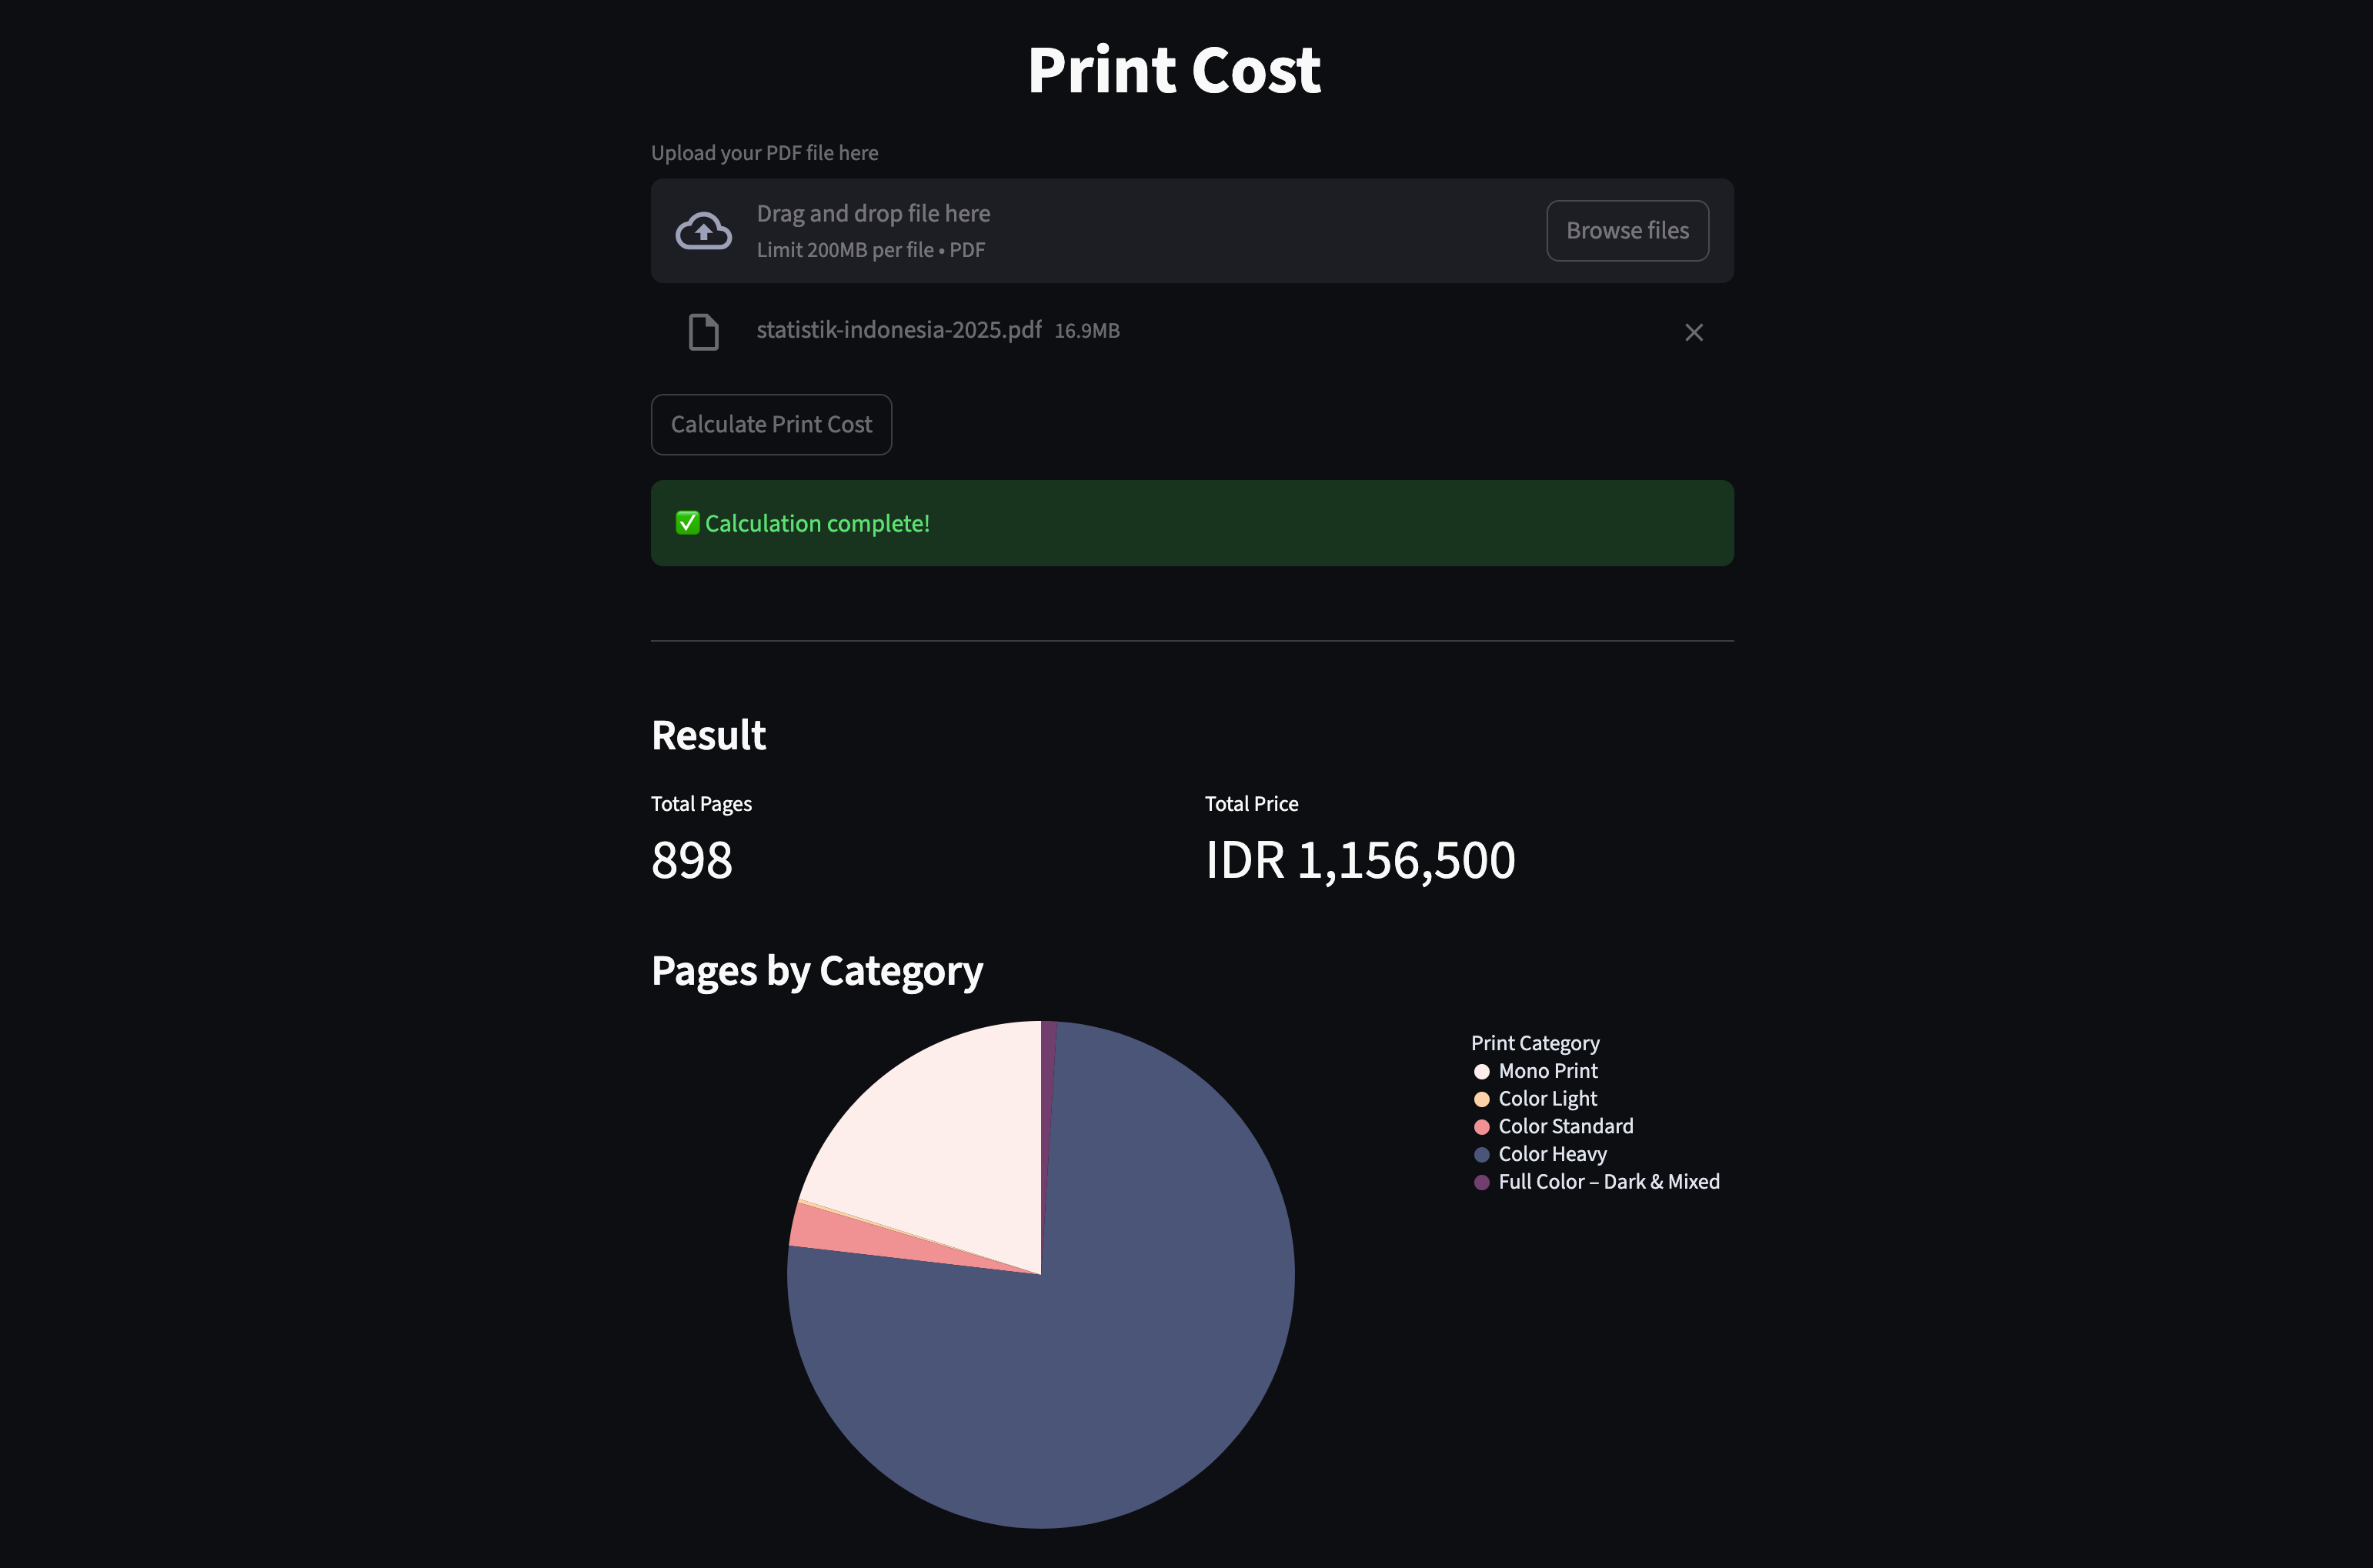
Summary
Print-Cost aku bangun dari pengalaman pribadi waktu masih kuliah, saat aku menjalankan usaha cetak kecil-kecilan. Waktu itu menentukan harga dokumen masih manual — banyak mengandalkan feeling, pengalaman, dan hitungan cepat di kepala sambil menahan antrean pelanggan yang panjang.
Usahanya sekarang sudah tidak jalan lagi karena aku sudah kerja full-time, tapi masalahnya masih sangat nyata. Project ini jadi cara aku kembali ke titik masalah usaha lama itu dan menyelesaikannya dengan benar pakai Machine Learning dan Data Science.
Background Problem
Waktu masih mengoperasikan toko cetaknya, aku sering harus:
- Melayani pelanggan yang mau cetak dokumen
- Menghitung harga cetak halaman per halaman
- Melayani penjualan alat tulis (ATK) di saat yang sama
Tantangannya, harga cetak tidak sesederhana hitam-putih. Ada halaman yang full color, ada yang isinya hampir hitam semua, ada juga yang cuma punya sedikit elemen berwarna seperti logo. Saat jam sibuk, menghitung harga dengan akurat sambil menjaga antrean tetap jalan itu bikin stres dan rawan salah.
Dari sisi pelanggan, pengalamannya juga tidak ideal:
- Mereka tidak punya estimasi harga yang jelas sebelum datang ke toko
- Biaya akhirnya terasa tidak bisa ditebak
- Kadang ini bikin pelanggan tidak puas, padahal operatornya tidak berniat buruk sama sekali
Rata-rata butuh sekitar 1 detik per halaman hanya untuk menentukan kategori harganya saja. Kedengarannya kecil, tapi jadi bottleneck serius untuk dokumen yang ratusan halaman.
The Idea
Dari pengalaman itu, muncul satu pertanyaan sederhana:
“Kenapa biaya cetak masih harus dihitung manual, padahal dokumen itu pada dasarnya data?”
Pertanyaan itu jadi dasar project ini.
Tujuannya membangun sistem yang bisa otomatis:
- Menganalisis tiap halaman dokumen
- Mengukur pemakaian tinta
- Menentukan kategori harga yang adil dan konsisten
Bukan cuma lebih cepat — tapi juga lebih konsisten dan transparan, baik untuk operator maupun pelanggan.
Approach
1. Feature Extraction
Tiap halaman PDF diubah jadi gambar, lalu dikonversi dari RGB ke ruang warna CMYK. Dari situ bisa dihitung persentase pemakaian tinta Cyan, Magenta, Yellow, dan Black per halaman.
2. Labeling with K-Means Clustering
Karena dataset awalnya belum punya label harga, aku pakai K-Means clustering untuk mengelompokkan 884 halaman ke 33 cluster berdasarkan kemiripan warnanya.
Cluster itu lalu aku petakan secara manual ke 5 kategori harga (Rp500–Rp2000), dan cara ini bikin proses labeling jadi 24× lebih cepat dibanding melabeli halaman satu per satu.
3. Classification with XGBoost
Setelah datanya punya label, aku melatih classifier XGBoost. Setelah coba-coba beberapa setting kualitas, 7 DPI jadi pilihan paling efisien — feature extraction-nya cepat dengan dampak minimal ke performa model.
Impact
Walaupun project ini berangkat dari usaha kecil yang sekarang sudah tidak jalan, hasilnya cukup signifikan:
- 🚀 109× lebih cepat dibanding hitung manual (109 halaman per detik)
- ⏱️ Dokumen 884 halaman bisa dihitung harganya dalam 8.13 detik
- 🎯 F1 Score 99%, dengan error handling yang berpihak ke bisnis:
- Lebih toleran kalau harganya sedikit kurang
- Aktif menghindari menagih terlalu mahal ke pelanggan
Di luar performa model, project ini juga memperbaiki pengalaman pelanggan:
- 📄 Ringkasan visual sederhana yang menampilkan jumlah halaman dan harga akhir
- 🥧 Pie chart berisi distribusi kategori harga berdasarkan intensitas warna tiap halaman
- 🖱️ Visualisasi interaktif dengan tooltip, jadi pelanggan bisa lihat:
- Berapa halaman yang masuk ke tiap kategori harga
- Kenapa dokumen tertentu lebih mahal dari yang lain
Visual ini bikin penetapan harga jadi lebih transparan dan gampang dimengerti, sekaligus membangun kepercayaan antara jasa cetak dan pelanggannya.
Dari sini kelihatan, masalah operasional sesederhana ini pun bisa diubah jadi solusi berbasis data yang scalable dan menguntungkan dua sisi: bisnis dan pengguna akhir.
Try It Yourself
Kalau penasaran bagaimana ini bekerja di praktiknya, kamu bisa lihat implementasinya sekaligus aplikasi live-nya:
-
🔗 GitHub Repository:
https://github.com/rasyidev/print-cost -
🚀 Live Demo:
https://rasyidev-print-cost.hf.space
Repository-nya berisi source code lengkap dan pipeline model, sedangkan live demo-nya membiarkan kamu lihat langsung bagaimana biaya cetak dihitung dan divisualisasikan secara real time.
Closing Thoughts
Print-Cost bukan cuma project Machine Learning buat aku.
Ini masalah nyata yang aku alami sendiri, lalu aku datangi lagi dengan tools dan pengalaman yang lebih baik.
Walau usaha cetaknya sudah tidak aktif, masalah yang sama masih ada di banyak toko cetak kecil sampai sekarang. Lewat project ini aku ingin menunjukkan bagaimana Data Science bisa benar-benar memperbaiki operasional usaha kecil — bukan cuma di teori, tapi di praktik.